X-Macro로 중복 없애기: enum↔문자열 매핑, 에러 코드 표, 상태 머신, 커맨드 테이블
enum을 정의하고, 같은 값의 이름 문자열 배열을 따로 만들고, switch로 to_string을 구현해 두면 새 값을 추가할 때마다 세 곳을 함께 고쳐야 합니다. 한 곳이라도 빠뜨리면 컴파일은 되는데 로그에 엉뚱한 이름이 찍히거나 배열 범위를 벗어나는 버그가 생깁니다. 에러 코드마다 숫자·메시지·HTTP 상태가 있는 경우, 상태 머신의 상태와 전이 표, CLI 커맨드의 이름·설명·핸들러처럼 “같은 목록을 여러 형태로 반복 정의”하는 상황은 어디에나 있습니다.
X-Macro는 이 목록을 한 곳에만 적고, 전처리기 매크로를 매번 다르게 정의해 그 목록으로부터 enum, 문자열 표, switch 문, 등록 코드를 생성하는 기법입니다. 이 글은 기본 원리부터 enum↔문자열 변환, 에러 코드 표, 상태 머신, 커맨드 테이블 예제와 자주 하는 실수까지 다룹니다.
flowchart TD
    subgraph source["단일 소스 (데이터 정의)"]
        D["X(RED)\nX(GREEN)\nX(BLUE)"]
    end
    subgraph gen1[매크로 X = enum 생성]
        E["enum  RED, GREEN, BLUE"]
    end
    subgraph gen2[매크로 X = 문자열 배열]
        S["#quot;RED#quot;, #quot;GREEN#quot;, #quot;BLUE#quot;"]
    end
    subgraph gen3[매크로 X = switch case]
        W["case RED: return #quot;RED#quot;; ..."]
    end
    D --> E
    D --> S
    D --> W
X-Macro 기초
기본 구조
데이터는 별도 파일에 X(...) 형태로만 나열하고, X는 그 파일을 #include하는 쪽에서 정의합니다. 이름 “X”는 관례일 뿐이라 ITEM, ENTRY 등 무엇이든 쓸 수 있습니다.
// colors.def
X(RED)
X(GREEN)
X(BLUE)
// main.cpp - enum 생성
enum class Color {
#define X(ID) ID,
#include "colors.def"
#undef X
};
// 전개 결과:
// enum class Color {
// RED,
// GREEN,
// BLUE,
// };// main.cpp - 문자열 배열 생성
const char* color_names[] = {
#define X(ID) #ID,
#include "colors.def"
#undef X
};
// 전개 결과:
// const char* color_names[] = {
// "RED",
// "GREEN",
// "BLUE",
// };#define X(ID) ID,와 #define X(ID) #ID,로 같은 colors.def를 서로 다른 형태로 전개했습니다. #ID는 매크로 인자를 문자열 리터럴로 만드는 문자열화 연산자입니다.
flowchart LR
    A["colors.def\nX(RED)\nX(GREEN)\nX(BLUE)"] --> B["#define X(ID) ID,"]
    B --> C[RED,\nGREEN,\nBLUE,]
    A --> D["#define X(ID) #ID,"]
    D --> E["#quot;RED#quot;,\n#quot;GREEN#quot;,\n#quot;BLUE#quot;,"]
최소 동작 예제
// main.cpp
#include <iostream>

enum class Color {
#define X(ID) ID,
#include "colors.def"
#undef X
};

const char* to_string(Color c) {
    switch (c) {
#define X(ID) case Color::ID: return #ID;
#include "colors.def"
#undef X
    }
    return "unknown";
}

int main() {
    std::cout << to_string(Color::GREEN) << "\n";  // GREEN
}
이제 colors.def에 X(BLACK) 한 줄만 추가하면 enum과 to_string이 함께 바뀝니다. switch에 default를 두지 않고 함수 끝에 return을 둔 이유는 뒤의 “자주 하는 실수”에서 설명합니다.
파일 대신 리스트 매크로로 쓰기
별도 .def 파일 대신, 목록 자체를 “생성 매크로를 인자로 받는 매크로”로 정의하는 방식도 널리 쓰입니다.
// colors.h
#define COLOR_LIST(X) \
    X(RED)            \
    X(GREEN)          \
    X(BLUE)

#define AS_ENUM(ID)   ID,
#define AS_STRING(ID) #ID,

enum class Color { COLOR_LIST(AS_ENUM) };
inline const char* const color_names[] = { COLOR_LIST(AS_STRING) };
이 방식은 생성 매크로마다 이름을 따로 붙이므로 #undef X를 짝지을 필요가 없고, 목록이 헤더 안에 있어 파일이 하나 줄어듭니다. 대신 목록이 길면 줄마다 \를 붙여야 하고, 목록 전체가 한 줄로 전개되어 컴파일 오류의 위치가 그 한 줄로 뭉뚱그려 표시됩니다. 항목이 많고 자주 바뀌는 목록은 .def 파일, 짧은 목록은 리스트 매크로가 편한 경우가 많습니다.
enum ↔ 문자열 매핑
양방향 변환
// log_level.def
X(Debug)
X(Info)
X(Warn)
X(Error)
// log_level.h
#pragma once
#include <optional>
enum class LogLevel {
#define X(L) L,
#include "log_level.def"
#undef X
};
const char* to_string(LogLevel level);
std::optional<LogLevel> from_string(const char* s);// log_level.cpp
#include "log_level.h"
#include <cstring>
const char* to_string(LogLevel level) {
switch (level) {
#define X(L) case LogLevel::L: return #L;
#include "log_level.def"
#undef X
}
return "Unknown";
}
std::optional<LogLevel> from_string(const char* s) {
#define X(L) if (std::strcmp(s, #L) == 0) return LogLevel::L;
#include "log_level.def"
#undef X
return std::nullopt; // 알 수 없는 문자열
}to_string(LogLevel::Warn)은 "Warn"을, from_string("Error")는 LogLevel::Error를 돌려줍니다. 파싱 실패를 임의의 기본값(예: Info)으로 돌려주면 오타가 조용히 묻히므로, std::optional로 실패를 드러내는 편이 안전합니다.
열거자 이름을 DEBUG, ERROR처럼 대문자로 짓지 않은 데는 이유가 있습니다. ERROR는 Windows 헤더(wingdi.h)에 #define ERROR 0으로 정의되어 있고, DEBUG는 빌드 옵션 -DDEBUG로 흔히 정의됩니다. 그런 매크로가 보이는 곳에서는 enum class LogLevel { DEBUG, ERROR }가 { , 0 }처럼 전개되어 알 수 없는 컴파일 오류가 납니다. enum이 매크로 이름과 겹치지 않게 짓는 것은 X-Macro와 상관없이 지켜야 하지만, X-Macro는 이름을 문자열로도 쓰므로 대소문자 표기까지 출력 형식에 영향을 준다는 점도 함께 고려해야 합니다.
개수 자동 계산
constexpr std::size_t log_level_count = 0
#define X(L) + 1
#include "log_level.def"
#undef X
;
// 전개: 0 + 1 + 1 + 1 + 1 = 4
목록에 항목을 추가하면 개수도 자동으로 따라갑니다. enum에 마지막 열거자로 Count_를 추가하는 방법도 흔하지만, 그러면 switch와 문자열 표에서 이 가짜 열거자를 따로 처리해야 합니다.
인덱스로 접근하는 문자열 배열
const char* const log_level_names[] = {
#define X(L) #L,
#include "log_level.def"
#undef X
};

static_assert(std::size(log_level_names) == log_level_count);
// 사용: log_level_names[static_cast<std::size_t>(LogLevel::Warn)]
배열 인덱스로 쓰려면 열거자 값이 0부터 연속이어야 합니다. 값을 따로 지정하지 않은 enum은 0부터 1씩 증가하므로 이 조건을 만족합니다. static_assert는 두 표가 같은 목록에서 생성되었다는 사실을 컴파일 타임에 한 번 더 확인해 줍니다.
표시용 문자열을 따로 두기
enum 이름과 출력용 문자열이 달라야 하면 인자를 두 개로 늘립니다.
// log_level.def - X(enum이름, 표시문자열)
X(Debug, "Debug")
X(Info,  "Information")
X(Warn,  "Warning")
X(Error, "Error")
// log_level.h
enum class LogLevel {
#define X(L, S) L,
#include "log_level.def"
#undef X
};// log_level.cpp
const char* to_string(LogLevel level) {
switch (level) {
#define X(L, S) case LogLevel::L: return S;
#include "log_level.def"
#undef X
}
return "Unknown";
}
// to_string(LogLevel::Info) → "Information"인자를 늘리면 그 .def를 쓰는 모든 #define X의 인자 개수도 함께 바꿔야 합니다. .def 파일 맨 위에 // X(enum이름, 표시문자열)처럼 인자 형식을 주석으로 남겨 두면 다음 사람이 헤매지 않습니다.
에러 코드와 메시지 표
에러 코드 + 숫자 + 메시지
// error_codes.def
// X(enum이름, 숫자값, 메시지)
X(Success,     0, "Success")
X(InvalidArg, -1, "Invalid argument")
X(NotFound,   -2, "Resource not found")
X(Timeout,    -3, "Operation timed out")
X(IoError,    -4, "I/O error")
// error_codes.h
#pragma once
enum class ErrorCode {
#define X(E, N, M) E = N,
#include "error_codes.def"
#undef X
};
const char* error_message(ErrorCode e);// error_codes.cpp
#include "error_codes.h"
const char* error_message(ErrorCode e) {
switch (e) {
#define X(E, N, M) case ErrorCode::E: return M;
#include "error_codes.def"
#undef X
}
return "Unknown error";
}열거자에 숫자 값을 직접 지정했으므로 숫자가 필요하면 static_cast<int>(e)로 얻을 수 있고, 별도의 error_number 함수는 필요 없습니다. 값이 0부터 연속이 아니므로 이 경우에는 배열 인덱스 대신 switch로 조회합니다.
배열로 조회하는 에러 표
값이 0부터 연속이라면 구조체 배열 하나로 여러 속성을 묶을 수 있습니다.
// error_codes.def - 0부터 연속
// X(enum이름, 메시지, 재시도 가능 여부)
X(Success,    "Success",             false)
X(InvalidArg, "Invalid argument",    false)
X(NotFound,   "Resource not found",  false)
X(Timeout,    "Operation timed out", true)
struct ErrorInfo {
const char* message;
bool retryable;
};
constexpr ErrorInfo error_table[] = {
#define X(E, M, R) { M, R },
#include "error_codes.def"
#undef X
};
// error_table[static_cast<std::size_t>(ErrorCode::Timeout)].retryable == trueHTTP 상태 코드 매핑
// http_status.def
// X(enum이름, 코드, 사유 문구)
X(Ok,                  200, "OK")
X(Created,             201, "Created")
X(BadRequest,          400, "Bad Request")
X(NotFound,            404, "Not Found")
X(InternalServerError, 500, "Internal Server Error")
enum class HttpStatus {
#define X(E, C, M) E = C,
#include "http_status.def"
#undef X
};
const char* http_status_message(HttpStatus s) {
switch (s) {
#define X(E, C, M) case HttpStatus::E: return M;
#include "http_status.def"
#undef X
}
return "Unknown";
}상태 머신
상태 정의
// states.def
X(Idle)
X(Running)
X(Paused)
X(Stopped)
// state_machine.h
#pragma once
enum class State {
#define X(S) S,
#include "states.def"
#undef X
};
enum class Event { Start, Pause, Resume, Stop, Reset };
const char* state_name(State s);
State transition(State current, Event ev);// state_machine.cpp
#include "state_machine.h"
const char* state_name(State s) {
switch (s) {
#define X(S) case State::S: return #S;
#include "states.def"
#undef X
}
return "Unknown";
}전이 표
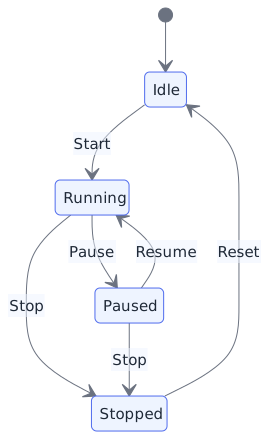
// transitions.def
// X(현재상태, 이벤트, 다음상태)
X(Idle,    Start,  Running)
X(Running, Pause,  Paused)
X(Running, Stop,   Stopped)
X(Paused,  Resume, Running)
X(Paused,  Stop,   Stopped)
X(Stopped, Reset,  Idle)
State transition(State current, Event ev) {
#define X(FROM, EV, TO) \
if (current == State::FROM && ev == Event::EV) return State::TO;
#include "transitions.def"
#undef X
return current; // 정의되지 않은 전이는 무시
}전이 표를 switch (current) { case State::FROM: ... }로 전개하고 싶을 수 있지만, 이 표에는 Running과 Paused가 두 번씩 나오므로 같은 case 레이블이 중복되어 컴파일 오류가 납니다. 상태별로 묶으려면 표를 상태 단위로 다시 구성해야 하고, 항목이 수십 개 수준이라면 위처럼 if를 나열하는 편이 단순합니다. 전이가 많아 성능이 중요하다면 X로 2차원 배열([상태][이벤트] → 다음 상태)을 채우는 방법도 있습니다.
CLI 커맨드 테이블과 디스패치
커맨드 이름, 설명, 핸들러 함수를 한 목록에서 정의합니다.
// commands.def
// X(이름, 설명, 핸들러 함수)
X(help,    "Show help",          cmd_help)
X(version, "Show version",       cmd_version)
X(quit,    "Exit program",       cmd_quit)
X(config,  "Show configuration", cmd_config)
// commands.cpp
#include <cstring>
#include <iostream>
using CommandHandler = int (*)(int argc, char** argv);
static int cmd_help(int, char**);
static int cmd_version(int, char**);
static int cmd_quit(int, char**);
static int cmd_config(int, char**);
struct Command {
const char* name;
const char* description;
CommandHandler handler;
};
static constexpr Command commands[] = {
#define X(N, D, H) { #N, D, H },
#include "commands.def"
#undef X
};
static int cmd_help(int, char**) {
std::cout << "Available commands:\n";
for (const auto& c : commands) {
std::cout << " " << c.name << " - " << c.description << "\n";
}
return 0;
}
static int cmd_version(int, char**) {
std::cout << "version 1.0\n";
return 0;
}
static int cmd_quit(int, char**) { return 0; }
static int cmd_config(int, char**) { /* ... */ return 0; }
static const Command* find_command(const char* name) {
for (const auto& c : commands) {
if (std::strcmp(c.name, name) == 0) return &c;
}
return nullptr;
}
int main(int argc, char** argv) {
if (argc < 2) {
return cmd_help(0, nullptr);
}
const Command* cmd = find_command(argv[1]);
if (!cmd) {
std::cerr << "Unknown command: " << argv[1] << "\n";
return 1;
}
return cmd->handler(argc - 2, argv + 2);
}이름, 설명, 핸들러를 구조체 배열 하나로 생성하면 help 출력과 디스패치가 같은 배열을 보므로 둘이 어긋날 수 없습니다. 핸들러가 상태를 갖지 않는 함수라면 std::function보다 함수 포인터가 가볍고, 배열 전체를 constexpr로 만들 수 있습니다. 커맨드마다 enum ID가 필요하다면 같은 commands.def로 enum class CommandId도 생성할 수 있습니다.
그 밖의 활용
같은 원리는 프로토콜 메시지 타입, 설정 키, 테스트·모듈 등록에도 그대로 쓰입니다.
// messages.def
// X(타입, 고정 크기(바이트))
X(Ping,   4)
X(Pong,   4)
X(Login,  64)
X(Logout, 4)
enum class MsgType {
#define X(T, SZ) T,
#include "messages.def"
#undef X
};
std::size_t message_size(MsgType t) {
switch (t) {
#define X(T, SZ) case MsgType::T: return SZ;
#include "messages.def"
#undef X
}
return 0;
}// modules.def
// X(모듈 이름, 초기화 함수, 종료 함수)
X(Network, init_network, shutdown_network)
X(Storage, init_storage, shutdown_storage)void init_all() {
#define X(M, I, S) I();
#include "modules.def"
#undef X
}
void shutdown_all() {
// 종료는 초기화의 역순이어야 하지만, 전처리기로는 목록을 뒤집을 수 없음
// 순서가 중요하면 함수 포인터 배열을 생성해 뒤에서부터 호출
#define X(M, I, S) S,
void (*const fns[])() = {
#include "modules.def"
};
#undef X
for (auto i = std::size(fns); i-- > 0;) fns[i]();
}모듈 종료 순서처럼 목록을 역순으로 처리해야 하는 경우는 전처리기만으로 해결할 수 없으므로, 위처럼 일단 배열을 생성한 뒤 C++ 코드로 순서를 다루는 것이 X-Macro를 쓸 때의 일반적인 요령입니다.
자주 하는 실수
그림: 실제 실행 결과 — 같은 colors.def에서 enum, switch, 이름 배열(3개)이 만들어진다. 인자 개수가 다르면 “too few arguments”, #undef 없이 다시 정의하면 macro redefined 경고, 쉼표가 없으면 enum에서 구문 오류가 난다. .def에 #pragma once가 있으면 두 번째 포함이 비어 배열 크기가 2와 0이 되고, default 없는 switch는 -Wswitch가 빠진 열거자를 알려 준다. (환경: macOS 27.0.1 · Apple clang 21.0.0 · -std=c++20)
인자 개수 불일치
colors.def가 X(RED)처럼 인자 하나인데 #define X(ID, NAME) NAME,처럼 두 인자를 받도록 정의하면, 전처리기가 “매크로 X는 인자 2개가 필요한데 1개만 주어졌다”는 오류를 냅니다. 목록 쪽의 인자 형식을 바꿨다면 그 목록을 쓰는 모든 #define X를 함께 고쳐야 합니다. .def 상단에 인자 형식을 주석으로 적어 두는 것이 가장 간단한 예방책입니다.
#undef X 누락
#define X(ID) ID,
#include "colors.def"
// #undef X 없음

#define X(ID) #ID,   // 경고: 'X' macro redefined
#include "colors.def"
#undef 없이 다른 내용으로 다시 정의하면 GCC와 Clang은 재정의 경고를 내고 새 정의로 진행하며, 경고를 오류로 다루는 빌드에서는 컴파일이 멈춥니다. 마지막 블록 뒤에 X가 남아 있으면 이후에 나오는 X(...) 모양의 코드가 모두 그 매크로로 전개됩니다. 참고로 int X = 42;처럼 뒤에 괄호가 없는 X는 함수형 매크로로 전개되지 않으므로 이 문제가 겉으로 드러나지 않을 수도 있습니다. #define X → #include → #undef X를 항상 한 묶음으로 쓰세요.
쉼표 위치
// enum에서 쉼표 누락
#define X(ID) ID
// → RED GREEN BLUE (구문 오류)

// 올바른 예
#define X(ID) ID,
// → RED, GREEN, BLUE,
생성 결과의 마지막 쉼표는 문제가 되지 않습니다. 배열 초기화 목록의 끝 쉼표는 C와 C++ 모두에서 항상 허용되고, enum의 끝 쉼표도 C++11과 C99부터 허용됩니다. C89나 C++03처럼 오래된 표준을 맞춰야 할 때만 마지막 열거자 뒤에 Count_ 같은 열거자를 하나 더 두는 식으로 피해 가면 됩니다.
.def 파일과 매크로 이름 불일치
// colors.def
COLOR(RED)
COLOR(GREEN)

// main.cpp
#define X(ID) ID,
#include "colors.def"  // COLOR가 정의되지 않아 COLOR(RED)가 그대로 남음
.def 파일에 쓴 매크로 이름과 #define하는 이름이 같아야 합니다. 이름을 맞추기 어렵다면 별칭을 둘 수도 있습니다.
#define X(ID) ID,
#define COLOR X
#include "colors.def"
#undef COLOR
#undef X
.def 파일에 include 가드
// colors.def
#pragma once   // 넣으면 안 됨
X(RED)
X(GREEN)
#define X(ID) ID,
#include "colors.def" // 정상 전개
#undef X
#define X(ID) #ID,
#include "colors.def" // #pragma once 때문에 아무것도 포함되지 않음
#undef XX-Macro는 같은 .def를 다른 X 정의로 여러 번 포함하는 패턴이므로, .def에는 #pragma once나 include 가드를 넣지 않습니다. 확장자를 .h가 아닌 .def나 .inc로 두는 관례도 “헤더가 아니라 여러 번 포함되는 데이터”라는 점을 드러내기 위해서입니다.
switch의 default
X-Macro로 switch를 생성하면 모든 열거자에 대한 case가 자동으로 만들어지므로, default를 두지 않는 편이 낫습니다. default가 없으면 누군가 생성 블록 밖에서 switch를 손으로 작성하다 열거자를 빠뜨렸을 때 GCC·Clang의 -Wswitch(-Wall에 포함)가 경고해 줍니다. 대신 정수를 캐스팅해 만든 범위 밖의 값이 들어올 수 있으므로, 함수 끝에 return "unknown";처럼 대체 반환을 둡니다. 이 글의 예제가 모두 그렇게 되어 있는 이유입니다.
문자열화와 매크로 확장
#ID는 인자를 매크로 확장하지 않은 채 그대로 문자열로 만듭니다. X(RED)에서 "RED"를 얻는 데는 문제가 없지만, 인자 자체가 다른 매크로 이름이고 그 확장 결과를 문자열로 만들고 싶다면 #define STR_(x) #x, #define STR(x) STR_(x)처럼 한 단계를 거쳐야 합니다.
X-Macro를 쓸지, 다른 방법을 쓸지
X-Macro가 가장 값을 하는 경우는 같은 목록에서 enum, 문자열 표, switch, 등록 코드처럼 서로 맞아야 하는 산출물이 셋 이상 나올 때입니다. 목록이 수십 개 수준이고 한 바이너리 안에서만 쓰인다면, 외부 도구 없이 동기화를 컴파일러에게 맡길 수 있다는 장점이 매크로의 가독성 비용보다 큽니다.
반대로 필요한 것이 enum↔문자열 변환 하나뿐이라면 magic_enum 같은 헤더 전용 라이브러리가 더 간단합니다. 다만 magic_enum은 컴파일러 내장 기능으로 값을 하나씩 훑기 때문에 기본 검사 범위(-128~127)를 벗어난 enum 값은 이름을 찾지 못하는 제약이 있어, 비트 플래그나 큰 값을 쓰는 enum이라면 범위 설정부터 확인해야 합니다. C++26 정적 리플렉션을 지원하는 컴파일러를 쓸 수 있다면 이런 용도는 언어 기능으로 해결됩니다. 목록을 다른 언어나 서비스와 공유해야 하거나 항목 수가 수백 개를 넘는다면, YAML·JSON 같은 원본에서 헤더를 생성하는 코드 생성기가 유지보수하기 쉽습니다.